Cloud et serveursPrestataire et contratMaintenance et pannes17 min temps de lecture21 530 caractères3 253 mots
SLA informatique — qu'est-ce que c'est et que vérifier dans un contrat avec un fournisseur
SLA informatique : combien d'indisponibilité tient dans 99,9 %, comment se comparent les SLA d'AWS, Microsoft et Google, SLO, RPO, RTO et 10 points à vérifier.
SLA informatique — qu'est-ce que c'est, et pourquoi ce terme apparaît-il dans chaque contrat avec un fournisseur cloud ? Il désigne un service level agreement : un document dans lequel un fournisseur inscrit la qualité de fonctionnement attendue de son service, et ce qui se passe s'il ne tient pas sa parole. Dans les services cloud et SaaS, cela se résume le plus souvent à un seul chiffre — un pourcentage de disponibilité mensuel, par exemple 99,9 %. Ce chiffre ressemble à une promesse que le service ne tombera presque jamais en panne. En pratique, il signifie quelque chose de bien plus modeste.
Cet article porte sur les SLA des fournisseurs cloud, des logiciels SaaS et des services informatiques dont dépend votre entreprise : messagerie, suites bureautiques, serveurs cloud. Nous montrons combien d'indisponibilité les niveaux SLA habituels autorisent réellement, comment se comparent les contrats d'AWS, de Microsoft et de Google, en quoi un SLA diffère d'un SLO, ce que signifient RPO et RTO, et comment un SLA se situe par rapport au droit suisse des contrats. À la fin, vous trouverez une liste de 10 points à vérifier avant de signer. Si vous cherchez un contrat de service pour un site web d'entreprise plutôt qu'un service cloud, c'est un sujet distinct, traité dans notre article sur la maintenance de site.
SLA informatique — la définition, et ce qu'un SLA n'est pas
La définition la plus précise que l'on puisse lire gratuitement vient de la norme ISO/IEC 17788:2014, publiée en parallèle par l'UIT sous forme de recommandation Y.3500. Au point 3.1.7, elle reprend une définition de la norme de gestion des services ISO/IEC 20000-1 (ITU-T Y.3500, 08/2014) :
> « service level agreement (SLA): Documented agreement between the service provider and customer that identifies services and service targets. »
En français — traduction libre : un accord de niveau de service est un accord documenté entre le fournisseur de services et le client qui identifie les services et leurs cibles. Deux remarques accompagnant cette définition comptent tout autant en pratique. D'abord, un SLA peut aussi s'appliquer entre un fournisseur et son sous-traitant, ou un service interne. Ensuite, un SLA « can be included in a contract or another type of documented agreement » — traduction libre : « peut être intégré dans un contrat ou un autre type d'accord documenté ». Dans le cloud, c'est généralement un document séparé auquel renvoient les conditions d'utilisation, et que le fournisseur peut mettre à jour.
Le guide de Microsoft sur la lecture d'un SLA le formule de façon plus pratique : « un engagement contractuel entre un fournisseur de services et un client, avec des conséquences définies pour des cibles non satisfaites » ; « Un contrat SLA est un ensemble d'engagements conditionnels » (Microsoft Learn, 31.03.2026). Le mot « conditionnels » est la clé de tout le sujet.
Ce qu'un SLA n'est pas. Un SLA n'est pas une garantie que le service ne tombera jamais en panne. Le fournisseur ne promet pas qu'une interruption n'arrivera pas — il promet ce qu'il fera si une interruption dépasse une limite convenue. Dans le cloud, cette conséquence est presque toujours un avoir de service : une réduction sur une facture future, pas un versement. Microsoft le dit sans détour : « Les crédits ne couvrent pas les revenus perdus, l'attrition des clients ou les dommages de réputation », et les fournisseurs « ne les appliquent généralement pas automatiquement ».
Combien d'indisponibilité tient dans 99,9 % — l'uptime en minutes
La disponibilité (uptime) dans un SLA est le pourcentage de temps pendant lequel un service fonctionne, mesuré sur une période donnée. L'indisponibilité autorisée suit une formule simple :
indisponibilité autorisée = (1 − SLA / 100) × nombre de minutes de la période
Un mois de 30 jours compte 43 200 minutes, une année de 365 jours 525 600 minutes. Pour 99,9 % sur un mois, cela donne 0,001 × 43 200 = 43,2 minutes. Le tableau ci-dessous montre les niveaux habituels (calculs propres) :
Niveau SLA | Indisponibilité par mois (30 jours) | Indisponibilité par an (365 jours) |
|---|---|---|
99 % | 432 min (7,2 h) | 87,6 h |
99,5 % | 216 min (3,6 h) | 43,8 h |
99,9 % | 43,2 min | 8,76 h |
99,95 % | 21,6 min | 4,38 h |
99,99 % | 4,32 min | 0,88 h (env. 53 min) |
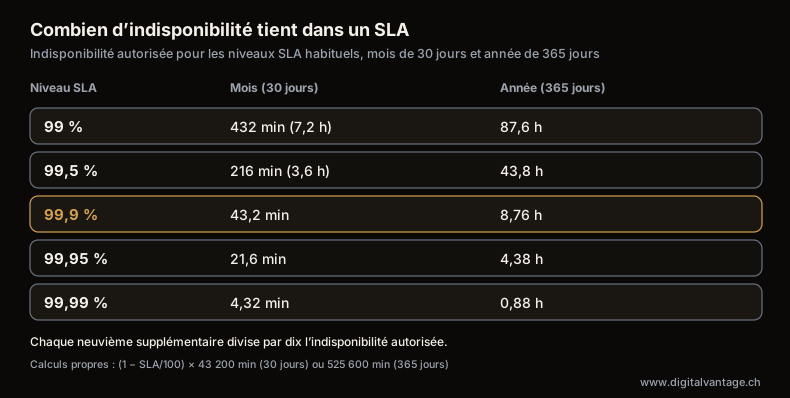
Combien d'indisponibilité tient dans un SLA
Calculs propres : (1 − SLA/100) × 43 200 min (30 jours) ou 525 600 min (365 jours)
Description du graphique
Tableau de l'indisponibilité autorisée pour les niveaux SLA habituels, mois de 30 jours et année de 365 jours. 99 % : 432 minutes par mois (7,2 heures), 87,6 heures par an. 99,5 % : 216 minutes par mois (3,6 heures), 43,8 heures par an. 99,9 % : 43,2 minutes par mois, 8,76 heures par an. 99,95 % : 21,6 minutes par mois, 4,38 heures par an. 99,99 % : 4,32 minutes par mois, 0,88 heure par an.
Deux constats découlent de ce tableau. D'abord, l'écart entre « deux neuf » et « quatre neuf » est l'écart entre plus de sept heures et quatre minutes par mois — ce ne sont pas des ajustements cosmétiques. Ensuite, les fournisseurs mesurent la disponibilité sur un mois, pas en temps réel : selon Microsoft Learn, « les contrats SLA mesurent généralement le temps d'activité sur une période de facturation, et non en temps réel ». Les 8,76 heures annuelles pour 99,9 % ne sont donc qu'une conversion illustrative. Un fournisseur peut respecter son SLA chaque mois, et une seule panne de 40 minutes au mauvais moment — par exemple le jour de clôture mensuelle — peut malgré tout arrêter votre entreprise.
Le tableau ne montre pas non plus ce que le fournisseur compte comme indisponibilité — et les exclusions ainsi que la définition de « non-disponibilité » peuvent faire que la panne réelle soit plus longue que celle des statistiques du SLA.
Comment se lisent réellement les SLA des grands fournisseurs
Voici trois documents dans les versions que nous avons lues : AWS et Google le 30 septembre 2026, l'édition française de Microsoft du 1er septembre 2026 le 2 octobre 2026.
AWS : Amazon Compute SLA (EC2)
Le document pour les serveurs virtuels EC2 date du 25 mai 2022 (« Last Updated: May 25, 2022 », AWS). Il contient deux niveaux d'engagement :
- 99,99 % au niveau région — s'applique aux instances déployées sur au moins deux zones de disponibilité ;
- 99,5 % au niveau d'une instance unique.
Les compensations sont un pourcentage des frais : pour la région, 10 % en dessous de 99,99 % mais au moins 99,0 % ; 30 % en dessous de 99,0 % mais au moins 95,0 % ; 100 % en dessous de 95,0 %. Pour une instance unique, le premier seuil est la plage de 99,0 % jusqu'à (sans l'atteindre) 99,5 %, les autres paliers étant identiques. AWS ne facture pas non plus une instance unique indisponible plus de six minutes au cours d'une heure donnée — le seul élément qui s'applique automatiquement.
Pour tout le reste, il faut le réclamer soi-même. Un avoir est accordé après une demande déposée dans l'AWS Support Center, qui doit parvenir avant la fin du deuxième cycle de facturation suivant l'incident. L'avoir n'est émis que s'il dépasse un dollar, et ne peut être appliqué qu'à des paiements futurs : « Service Credits will not entitle you to any refund » — traduction libre : « les avoirs de service ne vous donnent droit à aucun remboursement ». Le SLA exclut, entre autres, l'indisponibilité due à la force majeure, aux problèmes internet hors du périmètre de l'infrastructure EC2 d'AWS, et aux actes, omissions, matériel ou logiciels du client. La phrase la plus importante arrive à la fin : le SLA énonce « your sole and exclusive remedies » — traduction libre : « vos seuls et uniques recours » — en cas d'indisponibilité.
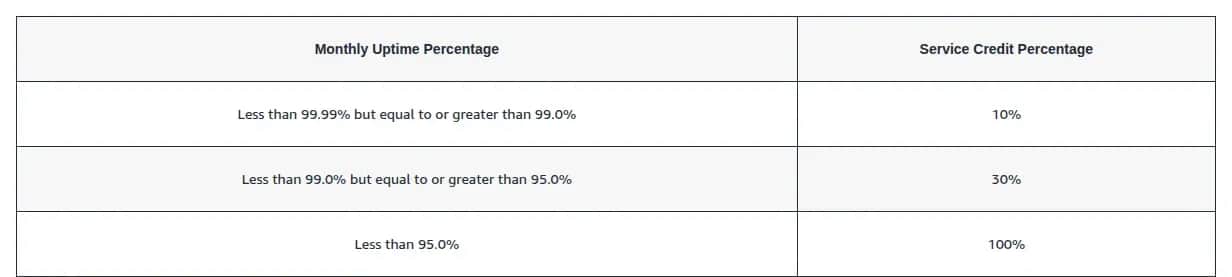
Tableau des avoirs du SLA Amazon EC2 (niveau région)
aws.amazon.com/compute/sla, capture d'écran du 30.09.2026
Microsoft : Contrat de Niveau de Service pour les Services en Ligne
Microsoft publie un document consolidé couvrant ses services en ligne : le « Contrat de Niveau de Service pour les Services en Ligne Microsoft, 1 septembre 2026 » (Microsoft, SLA pour les services en ligne). Sa clause de recours exclusif énonce : « Les Avoirs Service sont votre recours exclusif en cas de problèmes de fonctionnement ou de disponibilité pour tout Service dans le cadre du Contrat et du présent SLA. »
Le document ajoute que les avoirs « ne peuvent en aucun cas dépasser vos frais de Service mensuels » pour ce service, et ne seront pas accordés pour compenser d'autres pertes, « y compris, mais sans s'y limiter, toute perte de revenus, des coûts opérationnels ou toute perte indirecte ».
L'exclusion pour la maintenance planifiée compte aussi. Le « Temps d'Indisponibilité Planifié » est l'indisponibilité liée à la maintenance ou aux mises à niveau du réseau, du matériel ou du service, à propos duquel le document dit : « Nous publierons une notification ou vous informerons au minimum cinq (5) jours avant le début d'un tel Temps d'Indisponibilité. » Cette indisponibilité ne compte pas dans celle couverte par le SLA. Pour certains services, Microsoft abandonne cette exclusion : pour Exchange Online, le document indique qu'il n'y a « aucun Temps d'Indisponibilité Planifié pour ce service ».
Niveaux pour les services dont dépend la plupart des entreprises : Exchange Online et Teams — 99,9 %, avec un avoir de 25 % en dessous de 99,9 %, 50 % en dessous de 99 % et 100 % en dessous de 95 %. Pour Exchange, l'indisponibilité désigne une période pendant laquelle les utilisateurs ne peuvent pas envoyer ou recevoir de courrier via Outlook Web Access. Le délai de réclamation pour Azure est de 60 jours à compter de l'incident ; pour les autres services, il s'étend jusqu'à la fin de la Période Applicable suivant le mois de l'incident, et le traitement prend généralement jusqu'à 45 jours. Les préversions et les services ou niveaux de service fournis gratuitement n'ouvrent pas droit à des avoirs.
Google Workspace SLA
Le document de Google porte la date « Last modified: August 31, 2026 » (Google Workspace SLA) ; le document n'existe qu'en anglais. L'engagement : disponibilité mensuelle « at least 99.9% in any calendar month » — traduction libre : « au moins 99,9 % sur un mois calendaire quelconque ».
Google calcule les compensations différemment d'AWS et de Microsoft — en jours de service : 3 jours en dessous de 99,9 % (mais au moins 99,0 %), 7 jours en dessous de 99,0 % (au moins 95,0 %) et 15 jours en dessous de 95,0 %. L'avoir total sur un mois ne peut pas dépasser 15 jours. Les clients facturés hors ligne reçoivent les jours ajoutés à la fin de la période contractuelle, les clients payant en ligne reçoivent un avoir monétaire équivalent sur une facture future.
L'indisponibilité est une période pendant laquelle l'interface web du service présente « more than five percent user errors » — traduction libre : « plus de cinq pour cent d'erreurs utilisateur ». Une réclamation doit être déposée dans les 30 jours suivant le moment où le client est devenu éligible à l'avoir — passé ce délai, le droit s'éteint. Là aussi, le SLA constitue le « sole and exclusive remedy » du client — traduction libre : son seul et exclusif recours. Un détail : le document ne contient aucune exclusion pour la maintenance planifiée.
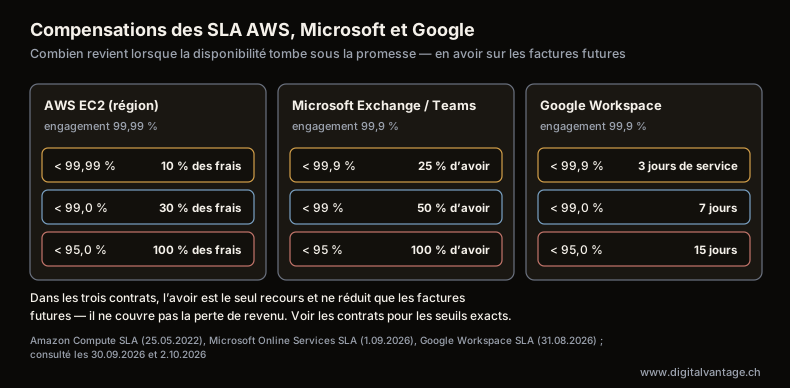
Compensations des SLA AWS, Microsoft et Google
Amazon Compute SLA (25.05.2022), Microsoft Online Services SLA (1.09.2026), Google Workspace SLA (31.08.2026) ; consulté les 30.09.2026 et 2.10.2026
Description du graphique
Comparaison des seuils de compensation. AWS EC2, niveau région, engagement 99,99 % : en dessous de 99,99 % (au moins 99,0 %) avoir de 10 %, en dessous de 99,0 % (au moins 95,0 %) 30 %, en dessous de 95,0 % 100 % des frais. Microsoft Exchange Online et Teams, engagement 99,9 % : en dessous de 99,9 % avoir de 25 %, en dessous de 99 % 50 %, en dessous de 95 % 100 %. Google Workspace, engagement 99,9 % : en dessous de 99,9 % (au moins 99,0 %) 3 jours de service, en dessous de 99,0 % (au moins 95,0 %) 7 jours, en dessous de 95,0 % 15 jours. Dans les trois cas, l'avoir est le seul recours et s'applique aux factures futures.
Ce que les trois documents ont en commun. La compensation prend la forme d'un avoir sur un service futur, il faut la réclamer dans un délai fixé, elle a un plafond, et c'est le seul recours que prévoit le contrat. Un avoir valant même 100 % de la facture mensuelle de messagerie représente généralement une fraction de ce que coûte réellement à votre entreprise une journée sans courrier.
Tableau de bord d'état de Google Workspace — le rapport public de disponibilité
google.com/appsstatus/dashboard, capture d'écran du 30.09.2026
Description du graphique
Capture d'écran du tableau de bord d'état de Google Workspace, en français : message « Aucune interruption signalée », heure de la dernière mise à jour, légende des statuts (disponible, information sur le service, problème mineur, interruption de service) et grille des jours pour des services tels que la console d'administration, Apps Script et AppSheet.
SLA, SLO et SLI — trois notions faciles à confondre
Dans les discussions sur la fiabilité, deux autres sigles accompagnent le SLA. Les définitions les plus citées viennent du livre de Google sur l'ingénierie de la fiabilité (Site Reliability Engineering), dans son chapitre sur les objectifs de niveau de service (Google SRE Book) :
- SLI — « An SLI is a service level indicator—a carefully defined quantitative measure of some aspect of the level of service that is provided. » — traduction libre : un indicateur de niveau de service, c'est-à-dire une mesure quantitative soigneusement définie d'un aspect du niveau de service fourni — par exemple la part de requêtes réussies ou le temps de réponse.
- SLO — « An SLO is a service level objective: a target value or range of values for a service level that is measured by an SLI. » — traduction libre : un objectif de niveau de service, c'est-à-dire une valeur cible ou une plage de valeurs pour un niveau de service mesuré par un SLI.
- SLA — « SLAs are service level agreements: an explicit or implicit contract with your users that includes consequences of meeting (or missing) the SLOs they contain. » — traduction libre : un accord de niveau de service, contrat explicite ou implicite avec vos utilisateurs, qui inclut des conséquences en cas d'atteinte (ou non) des SLO qu'il contient.
Les auteurs proposent un test simple : demandez-vous « what happens if the SLOs aren't met? » — traduction libre : « que se passe-t-il si les SLO ne sont pas atteints ? ». S'il n'y a pas de conséquence claire, vous avez presque certainement affaire à un SLO, pas à un SLA.
Pour un client, cette distinction a une portée pratique : une déclaration du type « nous visons 99,95 % de disponibilité » décrit un SLO — un objectif. Ce qui engage réellement le fournisseur, c'est le document qui relie le chiffre à une conséquence.
RPO et RTO — combien de données et combien de temps pouvez-vous perdre
Un SLA parle de disponibilité : combien de temps un service peut rester indisponible. Il ne dit rien de la quantité de données que vous perdrez après une panne grave, ni de la rapidité avec laquelle vous reprendrez le travail après un sinistre. Deux autres notions couvrent cela, décrites au mieux dans la publication NIST SP 800-34 Rev. 1 sur la planification de la continuité informatique, dans sa partie consacrée à l'analyse d'impact sur l'activité (NIST SP 800-34 Rev. 1, mai 2010, p. 17) :
> « Recovery Time Objective (RTO). RTO defines the maximum amount of time that a system resource can remain unavailable before there is an unacceptable impact on other system resources, supported mission/business processes, and the MTD. »
Traduction libre : le RTO (délai de reprise visé) définit le temps maximal pendant lequel une ressource système peut rester indisponible avant qu'il n'y ait un impact inacceptable sur les autres ressources, les processus métier qu'elle soutient, et le MTD — la durée maximale d'interruption tolérable d'un processus métier.
> « Recovery Point Objective (RPO). The RPO represents the point in time, prior to a disruption or system outage, to which mission/business process data can be recovered (given the most recent backup copy of the data) after an outage. »
Traduction libre : le RPO (point de reprise visé) est le moment, antérieur à une interruption ou à une panne, jusqu'auquel les données d'un processus métier peuvent être restaurées, à partir de la copie de sauvegarde la plus récente. Le NIST précise que le RPO exprime la quantité de perte de données qu'un processus métier peut tolérer.
En bref : le RTO répond à « combien de temps », le RPO à « depuis quel moment ». Si une sauvegarde est effectuée une fois par jour, le RPO est, dans le pire des cas, de 24 heures : tout ce qui a été saisi depuis la dernière sauvegarde devra être ressaisi à la main, ou sera simplement perdu. Aucun des trois SLA décrits plus haut ne contient d'engagement de RPO ou de RTO pour les données du client — ils parlent de la disponibilité du service, pas de la restauration de vos données. Ces paramètres doivent être fixés séparément, ou garantis par vous-même. Comment planifier les sauvegardes et la restauration d'un site web est expliqué dans notre article sur la sauvegarde de site.
Le SLA face au droit suisse
Un SLA avec un fournisseur étranger est régi par le droit désigné dans le contrat principal, mais le point de référence suisse pour les questions de responsabilité est le Code des obligations (CO). Art. 97(1) : « Lorsque le créancier ne peut obtenir l'exécution de l'obligation ou ne peut l'obtenir qu'imparfaitement, le débiteur est tenu de réparer le dommage en résultant, à moins qu'il ne prouve qu'aucune faute ne lui est imputable. » Sans aucun SLA, un fournisseur serait donc déjà responsable, sur la base des règles générales, du dommage causé par une exécution défectueuse — sauf s'il prouve qu'aucune faute ne lui est imputable.
L'art. 100(1) va plus loin que la règle générale : « Est nulle toute stipulation tendant à libérer d'avance le débiteur de la responsabilité qu'il encourrait en cas de dol ou de faute grave. » La règle couvre la faute grave, pas seulement le dol. Des clauses du type « l'avoir est le seul recours » limitent la responsabilité — et l'art. 100 fixe un plancher en dessous duquel de telles limites ne tiennent pas.
Sur les clauses pénales, l'art. 160(1) prévoit que lorsqu'une peine est promise pour le cas d'inexécution ou d'exécution imparfaite, « le créancier ne peut, sauf convention contraire, demander que l'exécution ou la peine convenue » ; l'art. 161(1) : « La peine est encourue même si le créancier n'a éprouvé aucun dommage », avec des dommages supplémentaires uniquement en cas de faute du débiteur (161(2)). L'art. 163(3) : « Le juge doit réduire les peines qu'il estime excessives. »
Un avoir de service est-il une peine conventionnelle ? Nous nous arrêtons ici délibérément. Un avoir ressemble à une peine conventionnelle — un montant fixé à l'avance pour une exécution défectueuse — mais il prend la forme d'une réduction sur des frais futurs plutôt que le paiement d'une somme déterminée. Nous n'avons trouvé aucune source tranchant cette question dans un sens ou dans l'autre. Si une part significative du chiffre d'affaires de votre entreprise dépend de la disponibilité d'un service, c'est exactement la question à poser à un avocat avant de signer — avec celle du droit applicable et du for.
DORA — ne s'applique pas ici. Le règlement (UE) 2022/2554 couvre les entités financières de l'UE et leurs contrats informatiques ; il ne s'applique pas directement en Suisse. La FINMA a ses propres règles sur l'externalisation, mais leur contenu n'a pas été consulté ici, donc nous ne les citons pas — si votre SLA s'inscrit dans une activité financière réglementée, vérifiez directement les circulaires de la FINMA.
L'équivalent suisse de NIS2. L'obligation suisse de signalement se trouve dans la loi sur la sécurité de l'information (LSI, RS 128) : en vigueur depuis le 1er avril 2025, avec des amendes possibles dès le 1er octobre 2025, elle impose un signalement à l'Office fédéral de la cybersécurité (OFCS) dans les 24 heures pour certains incidents, et les fournisseurs cloud et centres de données ayant leur siège en Suisse figurent parmi les entités assujetties. C'est une obligation de signalement, pas le régime complet de gestion des risques de NIS2 — une obligation plus étroite que la directive européenne à laquelle on la compare parfois.
10 points à vérifier dans un SLA avant de signer
Tout ce qui précède se résume en une liste. Elle s'applique à tout SLA — avec un grand fournisseur cloud, une plus petite société SaaS ou un prestataire informatique :
- Exclusions. Ce qui ne compte pas comme indisponibilité : force majeure, problèmes internet, actions du client lui-même, suspension de compte. Plus la liste est large, moins les « neuf » valent quelque chose.
- Maintenance planifiée. Est-elle exclue du calcul de disponibilité, avec quel préavis le fournisseur l'annonce-t-il (au moins 5 jours chez Microsoft), et existe-t-il un plafond pour sa durée ? Certains fournisseurs ne prévoient aucune exclusion.
- La méthode de mesure. Que signifie exactement « indisponible » : absence de réponse du serveur, taux d'erreur (au-delà de 5 % chez Google), impossibilité d'envoyer du courrier ? Sur quelle période le pourcentage est-il calculé — mois calendaire ou période de facturation ?
- Délai et forme de la réclamation. AWS : avant la fin du deuxième cycle de facturation. Google : 30 jours. Microsoft, pour Azure : 60 jours. Les avoirs ne sont généralement pas appliqués automatiquement — quelqu'un dans l'entreprise doit suivre et déposer les réclamations.
- Plafond de compensation. Le plus souvent 100 % de la facture mensuelle du service (Microsoft) ou 15 jours de service (Google) — indépendamment de la durée réelle de la panne.
- La clause de recours exclusif. Le SLA énonce-t-il que l'avoir est le seul droit du client ? Les trois fournisseurs présentés ici le formulent ainsi, ce qui signifie qu'un SLA ne donne pas droit à une indemnisation pour perte de revenus.
- Délai de réponse du support. La disponibilité est une chose, la rapidité avec laquelle quelqu'un répond à un signalement de panne en est une autre. Vérifiez si les délais de réponse figurent réellement dans le contrat, ou seulement sur une page de tarifs des plans de support.
- RPO et RTO. Le fournisseur indique-t-il seulement à partir de quel moment, et en combien de temps, il restaurera vos données ? Si non, supposez que vous devez l'assurer vous-même.
- Rapports de disponibilité. Le fournisseur publie-t-il un historique de disponibilité et d'incidents, ou devez-vous le mesurer vous-même simplement pour savoir si vous avez droit à un avoir ?
- Changement de fournisseur. Que deviennent vos données après la résiliation, sous quel format et dans quel délai les récupérerez-vous. Plus de détails sur la stratégie de sortie dans notre article sur la sécurité des données dans le cloud.
Le SLA pour une petite entreprise — ce qui se négocie, et ce qu'il faut assurer soi-même
La réponse honnête est la suivante : avec un grand fournisseur cloud, une petite entreprise ne négociera généralement rien. Les SLA d'AWS, de Microsoft et de Google sont des documents standards, acceptés avec les conditions d'utilisation, et leurs modifications sont publiées par le fournisseur. La négociation est réaliste surtout avec de plus petits éditeurs SaaS, des sociétés informatiques locales et des prestataires de logiciels sur mesure. Il vaut alors la peine de discuter des délais de réponse, d'un canal de signalement hors heures de bureau, des paramètres de sauvegarde, et du format dans lequel vous récupérerez vos données en cas de séparation. Le choix entre un service prêt à l'emploi et votre propre système — et la différence de responsabilité qui en découle — est traité dans notre article sur l'on-premise.
Puisqu'un avoir ne couvrira pas vos pertes, la véritable protection vient de ce que l'entreprise fait elle-même. Trois choses comptent le plus :
- Votre propre surveillance. Si vous ne savez pas quand un service a été indisponible, vous ne déposerez pas de réclamation à temps, et vous ne pourrez pas vérifier le rapport du fournisseur. Une simple surveillance externe de la disponibilité montre l'indisponibilité de votre point de vue, pas selon les statistiques du fournisseur. Comment cela fonctionne pour les sites web est expliqué dans notre article sur le monitoring de site.
- Vos propres sauvegardes. Un SLA couvre la disponibilité du service, pas vos données. Une sauvegarde conservée ailleurs que chez le service lui-même est le seul moyen de faire dépendre le RPO de vous, et non du fournisseur — voir notre article sur la sauvegarde de site.
- Un plan B pour quelques heures. Pour les processus qui ne peuvent pas s'arrêter — traitement des commandes, contact client, paiements — il vaut la peine de savoir à l'avance ce que vous ferez si un service est indisponible pendant une demi-journée : un canal de contact alternatif, une liste de commandes hors système, une personne responsable de la communication avec les clients.
Si le SLA qui vous intéresse concerne en réalité un site web d'entreprise plutôt qu'un service cloud, vous parlez en pratique d'un contrat de maintenance : délai de réponse, mises à jour, sauvegardes et surveillance. Ce sujet est traité dans notre article sur la maintenance de site, et le calculateur de coût de maintenance donne une idée approximative de ce que coûte ce type de suivi.
Et ensuite
Ce qu'est réellement le cloud computing, et en quoi les modèles IaaS, PaaS et SaaS diffèrent — et donc quelles couches sont couvertes par le SLA d'un fournisseur — est expliqué dans notre article sur le cloud computing. Plus de détails sur le modèle SaaS lui-même dans notre guide du SaaS. Si vous choisissez un fournisseur pour un système critique et souhaitez passer en revue le contrat avec quelqu'un qui connaît le volet technique, voyez notre conseil technologique.
FAQ
Questions fréquentes sur le SLA
Un SLA (service level agreement, accord de niveau de service) est un document dans lequel un fournisseur de services inscrit la qualité de fonctionnement attendue du service — dans le cloud, le plus souvent un pourcentage de disponibilité mensuel, par exemple 99,9 % — et ce qui se passe s'il n'atteint pas ce niveau. Un SLA ne garantit pas l'absence de panne. Il fixe seulement les conséquences du dépassement d'une limite d'indisponibilité, le plus souvent une réduction sur une facture future.
Sur un mois de 30 jours, un SLA de 99,9 % autorise 43,2 minutes d'indisponibilité, soit 8,76 heures par an. Formule : (1 − SLA/100) × nombre de minutes de la période. Les fournisseurs calculent généralement la disponibilité sur un mois ou une période de facturation, et la maintenance planifiée ainsi que d'autres exclusions prévues au contrat ne comptent souvent pas comme de l'indisponibilité.
Généralement pas au sens d'une indemnisation. Les SLA d'AWS, de Microsoft et de Google prévoient un avoir de service — un pourcentage des frais ou quelques jours de service, appliqués à des factures futures — et précisent qu'il s'agit du seul recours du client. Microsoft exclut explicitement toute compensation pour perte de revenus. Un avoir doit être réclamé dans le délai prévu par le contrat. Savoir si un tel avoir constitue une peine conventionnelle au sens du Code des obligations est une question à poser à un avocat.
Selon Google SRE, un SLO (service level objective) est une valeur cible pour un niveau de service, mesurée par un SLI. Un SLA est l'accord qui relie un SLO à des conséquences en cas de non-atteinte. Un test simple : si vous ne savez pas ce qui se passe quand une cible n'est pas atteinte, vous avez affaire à un SLO, pas à un SLA.
Selon le NIST SP 800-34, le RTO (recovery time objective) est le temps maximal pendant lequel un système peut rester indisponible avant que l'impact sur l'activité ne devienne inacceptable. Le RPO (recovery point objective) est le moment antérieur à une panne jusqu'auquel les données peuvent être restaurées à partir de la sauvegarde la plus récente — en somme, la quantité de données qu'une entreprise peut se permettre de perdre. Les SLA des fournisseurs cloud couvrent la disponibilité du service et ne contiennent généralement aucun engagement de RPO ou de RTO pour les données du client.
Vous voulez vérifier ce que votre SLA garantit vraiment ?
Nous passerons ensemble en revue les contrats dont dépend votre entreprise : disponibilité, exclusions, sauvegardes, et ce que vous devez assurer vous-même.
Articles connexes
- SaaS — définition et quand un logiciel par abonnement a du sens pour votre entreprise
Le SaaS expliqué simplement : la définition du NIST, des exemples pour les entreprises, et quand un abonnement logiciel vaut mieux qu'un système propre.
- 1.Multi-tenant : ce que c’est et comment choisir une architecture SaaS pour plusieurs clients
SaaS multi-tenant : single tenant contre multi-tenant, modèles silo/pool/bridge, Row Level Security, protection des données et choix d’un modèle pour un MVP.
- 2.On premise — ce que ça signifie et quand votre propre serveur gagne face au cloud
On premise, votre propre serveur : le coût complet, la fin du support de Windows Server 2016, et quand le cloud ou le VPS gagnent à la place.
- 3.ARR, MRR et churn : indicateurs SaaS, formules, benchmarks et pièges de mesure
ARR, MRR, churn, NRR, LTV:CAC et règle des 40 % : formules ChartMogul et Stripe, benchmarks avec leur échantillon, et les pièges des indicateurs SaaS.
- 4.Application SaaS : comment construire son propre produit, du MVP aux paiements récurrents
Application SaaS, du MVP à l’abonnement : les cinq briques, les paiements récurrents en Suisse, le minimum légal, les coûts et l’exemple DVN Links.
- 5.Cloud computing — définition et différences entre IaaS, PaaS et SaaS
Le cloud computing selon le NIST : cinq caractéristiques, IaaS, PaaS et SaaS, cloud public, privé et hybride, et comment les entreprises l'adoptent.
- 6.Idées de micro-SaaS 2026 — 35 outils de niche à construire
35 idées de micro-SaaS classées par secteur, une grille de sélection de niche, un plan de MVP en 30 jours et la TVA suisse pour vendre à l’étranger.
- 7.Sécurité du cloud : qui est responsable de quoi, et que demander à votre fournisseur
Sécurité du cloud : répartition des responsabilités, contrat de sous-traitance, transferts vers les États-Unis, LSI et 10 questions à poser avant de signer.
- 8.Freemium ou essai gratuit ? Le modèle d’abonnement SaaS en chiffres
Freemium, essai sans carte ou avec carte : conversion ChartMogul, time-to-value, churn, MRR, LTV:CAC et l’adoption du cloud en Europe.
- 1.