Référencement (SEO)Analyse et mesure20 min temps de lecture26 213 caractères3 947 mots
Google Search Console : ce que c’est et comment l’utiliser en entreprise
La Google Search Console sans approximation : validation, accès pour l’agence, CTR et position moyenne selon Google, états d’indexation des pages.
Selon Google, la Search Console aide tous les propriétaires de sites web « à mieux comprendre les performances de leur contenu dans la recherche Google » (Google Search Central, mise à jour du 18 décembre 2025, consulté le 5 octobre 2026). Elle montre ce qui se passe dans Google avant le clic : si une page est indexée, sur quelles requêtes elle apparaît, à quelle position et à quelle fréquence on clique dessus.
Chacun de ces chiffres a une définition propre à Google qui n’est pas celle que suggère l’intuition. La position moyenne est celle du lien le mieux classé de votre site, en moyenne sur les requêtes, et non la moyenne de tous vos liens. Une impression compte même si personne n’a fait défiler la page jusqu’au résultat. Les requêtes rares entrent dans le total du graphique, mais pas dans le tableau. La mention « Cette URL est sur Google » ne signifie pas que l’adresse s’affichera dans les résultats. Et demander une indexation, le premier réflexe de la plupart des gens, ne garantit rien. Nous décrivons ci-dessous chaque rapport avec les définitions de Google, puis nous montrons à quoi chacun ressemble sur les données de notre propre blog.
Google Search Console : ce que c’est et à quoi elle sert
Selon les termes de la documentation, la Search Console « fournit des informations sur la manière dont Google explore, indexe et affiche les sites Web » (Google Search Central, consulté le 5 octobre 2026). On la cherche aussi sous les noms « search console » ou « google webmaster » ; c’est le même service.
Inutile de vous connecter tous les jours. Google l’écrit sans détour : si des problèmes sont détectés sur votre site, vous en serez informé par e-mail, et il conseille de consulter le compte environ une fois par mois ou après une modification du contenu. Un sitemap n’est pas nécessaire pour apparaître dans Google (les pages peuvent être découvertes sans lui), mais son envoi via la Search Console « peut accélérer la détection de votre site » (même source).
La Search Console s’arrête au clic ; ce que fait ensuite le visiteur, c’est Google Analytics qui le mesure. Ce partage des rôles, et la manière de s’en servir pour un diagnostic, nous le traitons dans notre article sur les KPI d’un site web. Voici deux points que cet article n’aborde pas.
L’association avec GA4. Une fois une propriété Search Console associée à un flux de données GA4, l’intégration ajoute deux rapports Search Console dans Analytics. La Search Console conserve les données des 16 derniers mois, donc les rapports d’Analytics couvrent eux aussi 16 mois au maximum, et les données arrivent dans les deux outils 48 heures après leur collecte par la Search Console. Les métriques Search Console ne se combinent qu’avec trois dimensions Analytics : page de destination, appareil et pays. Un flux de données web ne s’associe qu’à une seule propriété Search Console (aide Google Analytics, consulté le 5 octobre 2026 ; la page n’indique pas de date de mise à jour).
Pourquoi un clic dans la Search Console n’est presque jamais une session dans GA4. Google consacre un document à la question et commence par une précaution : clics et sessions sont calculés différemment, les chiffres diffèrent donc, et un petit écart peut être ignoré ; ce qui compte, c’est que les tendances générales soient similaires. Pour un écart important, Google énumère les causes suivantes (Google Search Central, mise à jour du 8 janvier 2026, consulté le 5 octobre 2026) :
- Implémentation d’Analytics — GA4 ne voit que ce que la balise collecte, et la balise peut manquer sur certaines pages ; les données de la Search Console sont traitées de la même manière pour toutes les propriétés.
- Consentement — quand les visiteurs refusent le suivi, Analytics compte moins de sessions (détails dans notre article sur Google Consent Mode).
- Fuseau horaire — Analytics utilise celui que vous avez choisi ; la Search Console compte les jours à l’heure du Pacifique (PT), si bien que pour un site mesuré à l’heure suisse, une journée Search Console va d’environ 9 h à 9 h.
- Attribution — Analytics attribue les sessions selon un modèle d’attribution ; la Search Console comptabilise chaque clic dans la recherche Google.
- URL canoniques — la Search Console n’inclut que l’URL canonique dans la recherche Google ; Analytics inclut toutes les URL qui contiennent le code de suivi.
- Répartition du trafic — la Search Console classe le trafic en Web, Images, Vidéos, Actualités et Discover ; Analytics le répartit autrement.
- Pages non HTML — les PDF affichés ou cliqués dans la recherche figurent dans la Search Console, alors qu’Analytics ne les mesure parfois pas du tout.
- Robots — Analytics exclut automatiquement les robots connus ; la Search Console ne les filtre pas nécessairement.
Ajouter un site à la Google Search Console : propriété de domaine ou préfixe d’URL
La première décision porte sur le type de propriété. L’aide de Google décrit deux types de base (aide Search Console, consulté le 5 octobre 2026) :
- La propriété de domaine inclut tous les sous-domaines (m, www et autres) et tous les protocoles (http, https, ftp). Elle se valide par un enregistrement DNS, sauf si le site est hébergé sur un service Google comme Blogger ou Google Sites.
- La propriété de préfixe d’URL ne comprend que les URL qui commencent par le préfixe indiqué, protocole compris :
https://www.example.com/ne couvre donc pashttp://example.com/.
Pour un site d’entreprise, la propriété de domaine est en général plus commode, car vous n’avez pas à surveiller les variantes avec et sans www. Le prix à payer est l’accès au DNS : si quelqu’un d’autre gère le domaine, il vous faudra son aide pour la validation. La même page d’aide mentionne aussi les propriétés de plate-forme (Instagram, TikTok, X, YouTube) et une limite de 1 000 propriétés par compte.
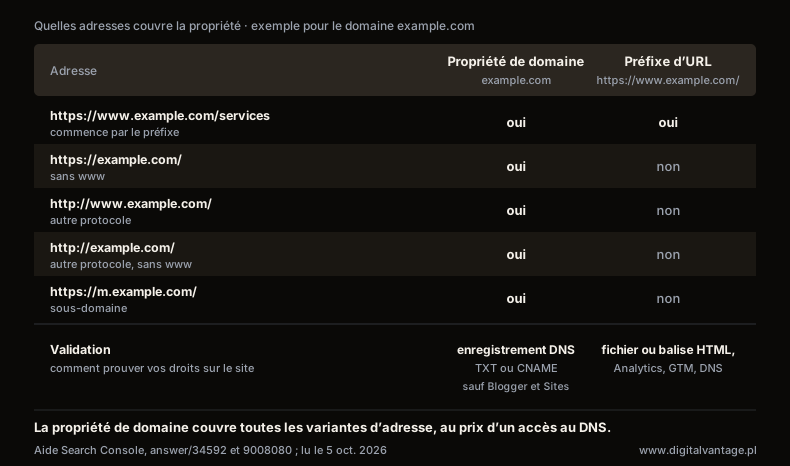
Propriété de domaine ou propriété de préfixe d’URL : quelles adresses chacune couvre
Aide Search Console, answer/34592 et answer/9008080 (support.google.com/webmasters, hl=fr) ; consulté le 5 octobre 2026
Description du graphique
Tableau de cinq adresses d’exemple pour le domaine example.com et deux types de propriété de la Search Console. La propriété de domaine example.com couvre les cinq : https://www.example.com/services, https://example.com/ sans www, http://www.example.com/ avec un autre protocole, http://example.com/, et le sous-domaine https://m.example.com/. La propriété de préfixe d’URL https://www.example.com/ ne couvre que la première adresse. Validation : propriété de domaine par un enregistrement DNS, TXT ou CNAME, sauf si le site est hébergé sur un service Google comme Blogger ou Google Sites ; propriété de préfixe d’URL aussi par fichier HTML, balise HTML, code Google Analytics, Google Tag Manager ou enregistrement DNS. Conclusion : la propriété de domaine couvre toutes les variantes d’adresse, au prix d’un accès au DNS.
La validation prouve que vous avez des droits sur le site. Méthodes selon l’aide de Google (consulté le 5 octobre 2026) : importation d’un fichier HTML, balise HTML, code de suivi Google Analytics, Google Tag Manager, compte Google Sites ou Blogger, et fournisseur de nom de domaine (un enregistrement TXT ou CNAME dans le DNS). Le fichier HTML ne fonctionne que pour une propriété de préfixe d’URL, pas pour une propriété de domaine.
Deux autres points de la même page d’aide. La validation reste valable tant que la Search Console peut confirmer la présence d’un jeton valide, ce qu’elle vérifie régulièrement. Si une refonte du site supprime le fichier ou la balise de validation, vous recevez une notification, et si le problème n’est pas corrigé, vos autorisations expirent après un délai de grâce. Par ailleurs, la collecte des données d’une propriété commence dès que quelqu’un l’ajoute, avant même la validation, mais il faut quelques jours pour que les données apparaissent.
La question plus large — comment faire en sorte que Google voie votre site — est traitée dans notre article sur le SEO et l’indexation.
Connexion et accès : qui dans l’entreprise, qui à l’agence
Vous vous connectez à la Google Search Console avec le compte Google propriétaire de la propriété ou ajouté comme utilisateur. Si votre site n’apparaît pas après la connexion, il y a deux voies : un propriétaire ajoute votre compte, ou vous validez vous-même la propriété avec l’une des méthodes ci-dessus. Si la connexion à la Search Console « ne marche pas », vérifiez d’abord avec quel compte Google vous êtes connecté.
Les rôles selon l’aide Search Console (consulté le 5 octobre 2026) :
- Propriétaire — validé ou délégué ; le propriétaire délégué reçoit ce statut d’un propriétaire, sans jeton de validation.
- Utilisateur avec accès complet — peut consulter toutes les données et réaliser certaines actions.
- Utilisateur avec accès limité — peut uniquement consulter la plupart des données.
- Associé — une personne ou un compte qui peut effectuer certaines actions au nom du site, mais ne peut ni ouvrir la Search Console ni consulter ses données.
Les règles qui ont des conséquences pour une entreprise : une propriété doit avoir au moins un propriétaire validé, sinon personne n’y a accès. Une propriété compte au plus 100 non-propriétaires. Des propriétaires délégués peuvent être ajoutés tant que le total des propriétaires validés et délégués n’atteint pas 500 ; le nombre de propriétaires validés n’est pas limité. Pour retirer un propriétaire validé, il faut supprimer son jeton de validation, faute de quoi la personne retirée peut simplement se valider à nouveau. La page d’aide ajoute une phrase à retenir : « Si vous identifiez un propriétaire que vous ne reconnaissez pas, il est possible que votre compte ait été piraté. »
Notre règle pratique, tirée de ces principes :
- L’entreprise est le propriétaire validé, sur un compte qui ne part pas avec un collaborateur.
- L’agence reçoit un accès complet ou limité, jamais la propriété. Seuls un propriétaire ou un utilisateur avec accès complet peuvent demander une indexation, si bien qu’un prestataire SEO a en général besoin de l’accès complet.
- À la fin du mandat, retirez les utilisateurs de l’agence et, si elle s’est validée avec son propre jeton, retirez aussi ce jeton.
Un accès en lecture suffit pour un audit ; ce qu’un audit fait de ces données, nous le décrivons dans notre article sur l’audit de site internet.
Le rapport sur les performances : clics, impressions, CTR et position moyenne
Par défaut, le rapport sur les performances affiche les clics et les impressions des trois derniers mois (aide Search Console, consulté le 5 octobre 2026). Vous pouvez ventiler les données par requête, page, pays, appareil, apparence dans les résultats de recherche et date, et choisir le type de recherche : Web (textuelle ou multimodale, c’est-à-dire une recherche où une image a été utilisée), images, vidéos et actualités.
Les définitions ci-dessous viennent de la page d’aide de Google « Que sont les impressions, les clics et la position ? » (consulté le 5 octobre 2026). Google précise que ces règles sont susceptibles d’évoluer.
Un clic est un clic qui mène l’internaute vers une page extérieure à la recherche Google, à Discover ou à Google Actualités. Cliquer sur un résultat, revenir en arrière et cliquer à nouveau sur le même lien ne compte que pour un seul clic.
Une impression signifie qu’un internaute a vu, ou potentiellement vu, un lien vers votre site. Elle est comptabilisée dès que le résultat figure sur la page de résultats ouverte, qu’il se trouve ou non dans la partie visible à l’écran. Les exceptions sont les carrousels et les éléments à développer, qui doivent réellement être affichés à l’écran ou développés.
CTR : ce que c’est
Le CTR (taux de clics) est le nombre de clics divisé par le nombre d’impressions. Par exemple, 50 clics pour 1 000 impressions donnent 5 % ; c’est de l’arithmétique, pas une valeur de référence. Comme une impression compte même quand personne n’a fait défiler la page jusqu’au résultat, le CTR peut baisser simplement parce que des impressions s’accumulent sur des positions basses ou sur des requêtes peu liées à la page. Un CTR faible peut trahir un titre faible, ou simplement une visibilité plus large.
Sur notre site polonais (digitalvantage.pl), propriété sc-domain:digitalvantage.pl, le CTR du site entier du 5 juillet au 2 octobre 2026 était inférieur à 0,1 %. Une réserve sur nos propres données : c’était une période de refonte du contenu du blog, pendant laquelle Google continuait à explorer à nouveau de nombreux articles. Comment rédiger des titres et des descriptions qui augmentent le CTR, nous l’expliquons dans notre article sur la rédaction SEO. Nous ne publions pas de références du type « CTR en première position », parce que Google n’en publie pas.
Position moyenne : comment Google la calcule
C’est là qu’on se trompe facilement. Pour Google, la valeur de position correspond à « la position la plus élevée occupée par un lien vers votre propriété ou votre page dans les résultats de recherche, déterminée grâce à la moyenne de toutes les requêtes entraînant l’affichage de votre propriété » — autrement dit, le lien le mieux classé de votre site, en moyenne sur toutes les requêtes où il est apparu.
L’exemple de Google : pour une requête, votre site a des liens en positions 2, 4 et 6, et c’est 2 qui compte. Pour une deuxième requête, il a des liens en positions 3, 5 et 9, et c’est 3 qui compte. La position moyenne vaut (2 + 3) / 2 = 2,5. Les autres liens ne tirent pas la moyenne vers le bas, parce qu’ils n’entrent jamais dans le calcul.
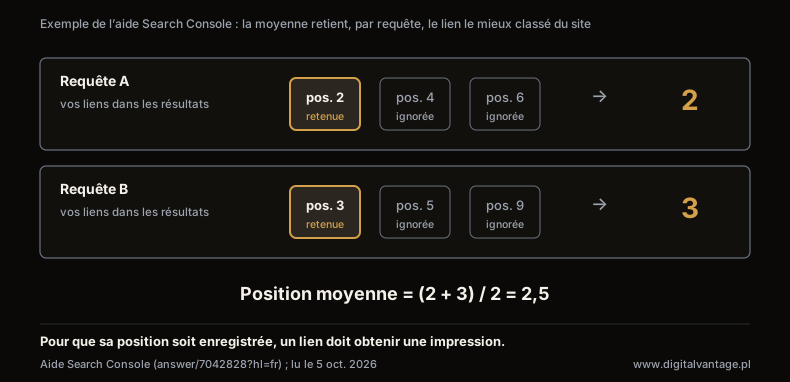
Comment la Search Console calcule la position moyenne
Aide Search Console, « Que sont les impressions, les clics et la position ? » (support.google.com/webmasters/answer/7042828?hl=fr) ; consulté le 5 octobre 2026
Description du graphique
Schéma de l’exemple donné par Google. Requête A : les liens du site apparaissent en positions 2, 4 et 6 ; la moyenne retient la plus élevée, soit 2. Requête B : liens en positions 3, 5 et 9 ; la moyenne retient 3. Position moyenne : (2 + 3) / 2 = 2,5. Pour que sa position soit enregistrée, un lien doit obtenir une impression.
Autres règles de la même page :
- Pour que sa position soit enregistrée, un lien doit recevoir une impression.
- Les annonces n’occupent pas de position.
- Les clics, les impressions et la position sont attribués à l’URL canonique du lien.
- Un aperçu IA occupe une seule position, et tous les liens qu’il contient reçoivent cette position ; les clics qu’on y fait comptent comme des clics ordinaires.
- Dans Discover, aucune position n’est enregistrée.
Google note aussi qu’un même numéro de position peut avoir des significations différentes selon les cas, et recommande de surveiller les changements de position au fil du temps, en particulier les changements soudains, en plus de la valeur elle-même. Comment ne pas se laisser tromper par ces chiffres (par exemple quand une seule requête de marque se répartit sur plusieurs adresses), nous l’expliquons dans notre article sur le SEO et l’indexation.
Comment connaître la position de votre site sur Google
Dans la Search Console, cela se fait dans le rapport sur les performances : filtrez par requête ou par page et lisez la colonne de position. Avant de conclure, gardez en tête la distinction que fait l’aide de Google : dans le graphique, la position moyenne se rapporte au résultat le mieux classé de l’ensemble du site ; dans le tableau, à l’URL ou à la ligne concernée. C’est pourquoi le chiffre au-dessus du graphique et ceux du tableau diffèrent, et tous sont exacts.
Deuxième piège : l’onglet des requêtes du tableau omet les requêtes anonymisées. Si une page a une position mais qu’aucune requête du tableau ne l’explique, c’est probablement de là que vient son trafic (voir la section suivante).
Pour séparer les requêtes de marque des autres, utilisez un filtre par expression régulière. Dans le filtre de requête ou de page, choisissez « Personnalisé (expression régulière) », puis « Ne correspond pas à l’expression régulière » pour exclure. La Search Console utilise la syntaxe RE2, la correspondance est partielle par défaut (l’expression peut correspondre à n’importe quelle partie de la chaîne, sauf si vous utilisez ^ ou $) et elle n’est pas sensible à la casse, sauf si vous ajoutez (?-i) au début de l’expression. Séparez les variantes par une barre verticale et placez l’expression entre parenthèses (aide Search Console, consulté le 5 octobre 2026). Par exemple, (digital vantage|digitalvantage) avec « Ne correspond pas à l’expression régulière » affiche les requêtes sans le nom de la marque. Le même filtre fonctionne sur les pages : sur un site multilingue, un filtre de page comme ^https://www\.example\.com/fr/ n’affiche que la partie en français. La même page d’aide avertit que filtrer par requête ou par URL peut modifier les totaux, en raison de la troncation des données et de l’omission des requêtes anonymisées.
Les limites des données : 16 mois, 1 000 lignes et les requêtes invisibles
Avant de comparer un rapport à quoi que ce soit, vérifiez ce qu’il laisse de côté.
Historique : 16 mois. Le chiffre vient de la page d’aide de Google Analytics sur l’intégration avec la Search Console : « Search Console conserve les données des 16 derniers mois » (aide GA4, consulté le 5 octobre 2026). Pour comparer des périodes plus longues, il faut exporter les données vous-même.
Fraîcheur. Selon la page d’aide sur les écarts de données, les données collectées sont généralement disponibles sous deux ou trois jours, et les jours (sauf dans la vue « 24 heures ») sont comptés à l’heure du Pacifique (aide Search Console, consulté le 5 octobre 2026). Dans la vue « 24 heures », les points du graphique représentent des heures et incluent des données préliminaires (aide Search Console). Dans GA4, les données de la Search Console apparaissent 48 heures après leur collecte. Dans l’API, le paramètre dataState distingue les données définitives (final, par défaut), l’ensemble des données y compris les plus récentes (all) et les données horaires (hourly_all), avec des dates comptées à l’heure du Pacifique (documentation de l’API, mise à jour du 11 août 2026, consulté le 4 octobre 2026).
Requêtes anonymisées. Ce sont des requêtes qui n’ont pas été saisies par plus de quelques dizaines d’utilisateurs sur deux à trois mois. Google les omet toujours des tableaux, mais les inclut dans les totaux du graphique, sauf si vous filtrez par requête (Search Central Blog, Daniel Waisberg, 19 octobre 2022, consulté le 4 octobre 2026). D’où une « incohérence » fréquente : la somme des lignes du tableau est inférieure au chiffre au-dessus du graphique.
Agrégation. Le graphique compte par propriété : si deux résultats de votre site apparaissent pour une même requête, c’est une seule impression. Le tableau par requêtes, pays, appareils et dates compte lui aussi par propriété, mais le tableau par pages et par apparence dans les résultats de recherche compte par page. C’est pourquoi les totaux du graphique et du tableau peuvent différer.
Exportation. L’interface exporte au plus 1 000 lignes ; les valeurs affichées comme ~ ou - sont exportées sous forme de zéros. Par l’API et Looker Studio, la limite est de 50 000 lignes par jour, par site et par type de recherche, même si, comme l’écrit Google, elle « may not be reached in all cases » (l’article du 19 octobre 2022 cité plus haut, publié en anglais). Pour les dimensions qui ne font intervenir ni requêtes ni pages (pays, appareil, apparence dans les résultats de recherche), la Search Console affiche et exporte toutes les données.
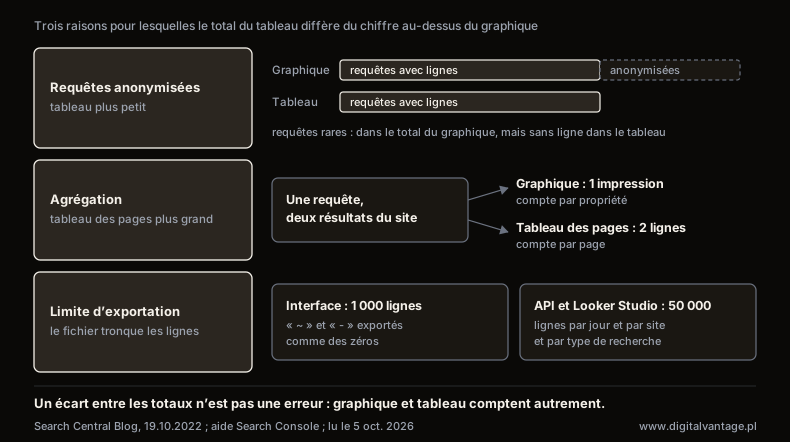
Pourquoi les totaux du graphique et du tableau ne concordent pas
Search Central Blog, « Performance data deep dive », 19 octobre 2022, et aide Search Console (hl=fr) ; consulté le 5 octobre 2026
Description du graphique
Schéma de trois raisons pour lesquelles le total du tableau du rapport sur les performances diffère du chiffre au-dessus du graphique ; proportions indicatives. Première, les requêtes anonymisées : les requêtes rares entrent dans le total du graphique mais n’ont pas de ligne dans le tableau, qui est donc plus petit que le graphique. Deuxième, l’agrégation : pour une requête où apparaissent deux résultats du site, le graphique compte par propriété 1 impression, le tableau des pages compte par page 2 lignes, si bien que le tableau des pages peut être plus grand. Troisième, la limite d’exportation : au plus 1 000 lignes depuis l’interface, et les valeurs affichées comme un tilde ou un tiret sont exportées comme des zéros ; par l’API et Looker Studio, jusqu’à 50 000 lignes par jour, par site et par type de recherche. Conclusion : un écart entre les totaux n’est pas une erreur, le graphique et le tableau ne comptent pas la même chose.
Le rapport sur l’indexation des pages : les états dans les mots de Google
Le rapport sur l’indexation des pages répond à une seule question : Google a-t-il votre page dans son index ? Nous donnons les noms des états tels que les écrit l’aide Search Console (consulté le 5 octobre 2026), avec notre propre explication à côté.
Deux états se confondent facilement, nous les plaçons donc côte à côte :
Détectée, actuellement non indexée | Explorée, actuellement non indexée | |
|---|---|---|
En clair | trouvée, pas encore chargée | chargée, mais pas indexée |
Ce que dit Google | la page a été détectée, mais pas encore explorée ; en règle générale, Google voulait l’explorer, mais a reporté l’exploration, car le site risquait d’être surchargé | la page a été explorée par Google, mais pas indexée ; elle sera peut-être indexée à l’avenir |
Google a-t-il chargé la page | non, la dernière date d’exploration ne figure donc pas dans le rapport | oui |
Conseil de la page d’aide | — | « il n’est pas nécessaire de renvoyer cette URL pour l’exploration » |
Le premier état relève du calendrier d’exploration ; le second est une décision prise après que Google a regardé la page. La page d’aide n’en donne pas la raison, contrairement aux états de pages en double, qui nomment la cause. Que faire des pages chargées puis écartées, nous l’expliquons dans notre article sur le SEO et l’indexation.
Autres raisons pour lesquelles une page n’est pas indexée, selon la même page d’aide :
- URL marquée "noindex" — la page demande elle-même à être exclue.
- URL bloquée par le fichier robots.txt — avec la réserve de Google : « cela ne garantit pas que la page ne sera pas indexée par d’autres moyens ».
- Erreur "soft 404" et Introuvable (404) — pour la seconde, Google note qu’il n’existe aucun moyen de demander à Googlebot d’oublier définitivement une URL. Plus de détails dans notre article sur l’erreur 404.
- Erreur serveur (5xx) — traitée dans notre article sur les erreurs serveur ; à côté, Erreur liée à des redirections et les blocages dus aux codes 401, 403 et autres 4xx.
- Autre page avec balise canonique correcte — une page alternative renvoie correctement vers la page canonique ; « vous n’avez donc aucune action à effectuer ».
- Page en double sans URL canonique sélectionnée par l’utilisateur — un doublon sans URL canonique déclarée ; Google en a choisi une autre et n’affichera pas celle-ci.
- Page en double : Google a choisi une autre URL canonique que l’utilisateur — vous avez déclaré une URL canonique, mais Google juge qu’une autre adresse convient mieux.
- Page avec redirection — l’adresse redirige.
Les pages indexées peuvent porter deux avertissements : Indexée malgré le blocage par le fichier robots.txt et Page indexée sans contenu. « Google ne reconnaît pas cette URL » ne fait pas partie de ce rapport : cette mention vient de l’outil d’inspection d’URL et signifie que Google n’a jamais détecté l’adresse (aide).
Des repères qui font gagner du temps, tirés de la même page d’aide :
- Si votre site compte moins de 500 pages, « ce rapport ne vous sera probablement d’aucune utilité » ; une recherche
site:suffit. - Ne vous attendez pas à ce que toutes les URL soient indexées : seules les pages canoniques doivent l’être.
- Être indexée ne garantit pas qu’une page figurera dans les résultats.
- Les listes d’exemples sont limitées à 1 000 entrées.
- La validation d’une correction prend généralement deux semaines environ, parfois beaucoup plus ; un problème quitte le tableau 90 jours après sa dernière occurrence.
- En général, vous ne pouvez corriger que les problèmes dont la source est « Site Web ».
Combien de temps prend l’indexation, et que faire quand une page attend des mois, nous le détaillons dans notre article sur le délai de référencement Google.
Notre propre site dans ce rapport : septembre et octobre 2026
Nous avons vérifié deux fois, le 9 septembre et le 3 octobre 2026, l’état d’indexation de chaque article de blog présent dans le sitemap (posts-sitemap.xml) de notre site polonais (digitalvantage.pl), par l’API URL Inspection. Entre ces deux dates, nous avons réécrit le contenu du blog. Les chiffres sont des parts des articles du sitemap à chaque date :
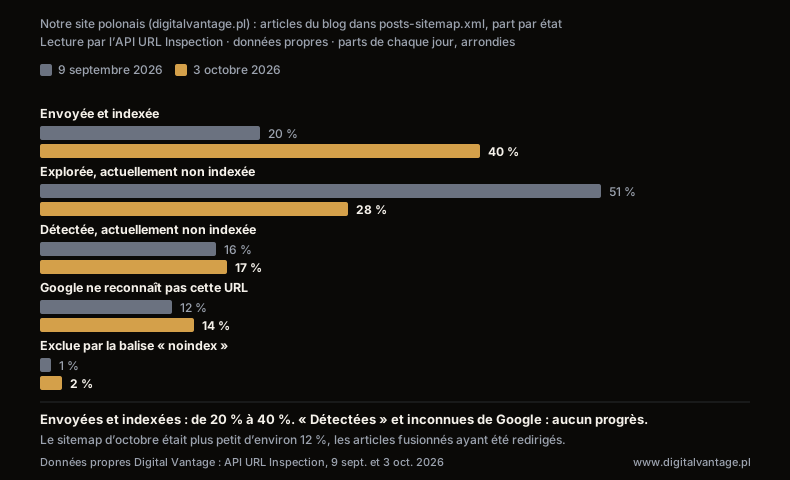
État d’indexation des articles du sitemap de notre site polonais (digitalvantage.pl) : 9 septembre et 3 octobre 2026
Données propres Digital Vantage : API URL Inspection, articles de posts-sitemap.xml de www.digitalvantage.pl (notre site polonais), 9 septembre et 3 octobre 2026 ; des parts, pas des nombres
Description du graphique
Barres horizontales groupées, part des articles du blog présents dans le sitemap (posts-sitemap.xml) au jour donné, sur notre site polonais (digitalvantage.pl). Envoyée et indexée : 20 % en septembre, 40 % en octobre. Explorée, actuellement non indexée : 51 % et 28 %. Détectée, actuellement non indexée : 16 % et 17 %. Google ne reconnaît pas cette URL : 12 % et 14 %. Exclue par la balise « noindex » : 1 % et 2 %. Ce sont des parts du sitemap des articles de chaque jour, et le sitemap d’octobre était plus petit d’environ 12 %, les articles fusionnés ayant été redirigés.
Dans nos données, la part des articles indexés a doublé, de 20 % à 40 %. La part des articles chargés mais non indexés est passée d’environ la moitié (51 %) à moins d’un tiers (28 %). Les parts des articles trouvés mais non chargés (16 % → 17 %) et inconnus de Google (12 % → 14 %) ne se sont pas améliorées.
Cela concorde avec les définitions de Google de la section précédente : réécrire le contenu peut changer une décision prise après que Google a vu une page, mais ni le calendrier d’exploration, ni le fait que Google ait trouvé l’adresse.
Deux réserves. D’abord, le dénominateur a changé : dans nos données, le sitemap d’octobre comptait environ 12 % d’articles de blog en moins, parce que nous avons redirigé des articles fusionnés ; une partie du mouvement vient donc de l’élagage d’articles faibles, pas seulement d’une réévaluation. Ensuite, nous avons déjà publié les parts de septembre dans notre article sur le SEO et l’indexation ; les chiffres d’octobre sont nouveaux.
Indexée ne veut pas dire visible. Du 5 juillet au 2 octobre 2026, 12 % des articles de blog du sitemap ont obtenu au moins une impression, contre 59 % des adresses du sitemap de notre section ressources (outils, rapports, modèles). Ces chiffres remplacent les 14 % et 54 % précédents, mesurés du 18 juin au 15 septembre 2026. Parmi les articles indexés le 3 octobre, 73 % n’avaient obtenu aucune impression sur cette fenêtre de 90 jours. Une réserve : Google a exploré à nouveau beaucoup d’entre eux après la réécriture, entre le 20 septembre et le 3 octobre 2026, si bien que la fenêtre mesure surtout les anciennes versions.
Inspection de l’URL et demande d’indexation : ce qu’elles font, et ce qu’elles ne font pas
L’outil d’inspection d’URL montre l’état d’une seule page. Selon l’aide Search Console (consulté le 5 octobre 2026), le résultat initial « ne constitue pas un test en ligne de l’URL » : il décrit la dernière version indexée de la page, pas la version actuelle. Et la mention « Cette URL est sur Google » ne garantit pas que la page apparaîtra dans les résultats.
Quand une page « ne s’indexe pas », commencez par l’URL canonique. La section Indexation des pages du résultat présente deux champs côte à côte :
- URL canonique déclarée par l’utilisateur — l’adresse que vous avez déclarée comme canonique (par une balise
<link rel="canonical">, un en-tête HTTP, un sitemap ou une autre méthode). Google en tient compte, sans garantir de la retenir. - URL canonique sélectionnée par Google — l’adresse que Google a choisie comme canonique parmi des pages similaires. Si une adresse inattendue apparaît ici, la page d’aide recommande de déclarer explicitement l’URL canonique.
Si les deux champs diffèrent, la page peut très bien se porter : c’est simplement une autre adresse qui figure dans l’index. C’est la situation derrière l’état « Page en double : Google a choisi une autre URL canonique que l’utilisateur » (aide). L’URL canonique sélectionnée par Google n’apparaît que dans le résultat indexé ; comme le dit Google, le test en ligne ne peut pas prédire le choix de l’URL canonique.
Le test en ligne a d’autres limites. Google indique qu’aucun test ne garantit l’indexation d’une page, et le test en ligne ne vérifie ni les doublons, ni le respect des consignes relatives à la qualité et à la sécurité, ni les actions manuelles, ni les suppressions de contenu.
La demande d’indexation, selon la documentation de Google (mise à jour du 31 décembre 2025, consulté le 5 octobre 2026) :
- seul un propriétaire ou un utilisateur avec accès complet peut l’envoyer ;
- l’exploration « peut prendre plusieurs jours, voire plusieurs semaines » ;
- elle ne garantit pas que l’inclusion dans les résultats se produira « instantanément », et « il est même possible qu’elle n’ait pas lieu du tout » ;
- un quota existe, mais Google n’en publie pas le chiffre, et les demandes répétées pour une même URL n’accélèrent pas l’exploration ;
- pour de nombreuses adresses, le sitemap est la bonne voie ;
- pour l’état « Explorée, actuellement non indexée », il n’est pas nécessaire de renvoyer l’URL (aide).
Les sitemaps dans la Search Console
Vous envoyez un sitemap dans le rapport sur les sitemaps, mais seulement avec les autorisations de propriétaire. Sinon, indiquez le sitemap dans votre fichier robots.txt (aide Search Console, consulté le 5 octobre 2026).
Le rapport affiche quatre états : Opération effectuée (toutes les URL sont mises en attente d’exploration), Contient des erreurs, Impossible de récupérer le sitemap et Inconnu. « Opération effectuée » ne veut pas dire « indexé » : mettre une URL en attente d’exploration ne garantit ni son exploration ni son indexation.
De la même page d’aide : supprimer un sitemap du rapport ne fait pas oublier à Google ce sitemap ni les URL qu’il contient. Le rapport n’affiche que les sitemaps envoyés par le rapport ou par l’API, avec un maximum de 1 000 demandes affichées. Dans le rapport sur l’indexation des pages, le filtre « Toutes les pages envoyées » limite la vue aux pages des sitemaps, que vous pouvez comparer aux pages hors sitemap.
Le rapport Core Web Vitals et le rapport Insights
Le rapport Core Web Vitals repose sur les données CrUX, collectées auprès d’utilisateurs réels de Chrome (aide Search Console, consulté le 5 octobre 2026). Il regroupe les pages similaires en groupes d’URL et affiche pour chaque groupe la valeur atteinte par 75 % des visites sur les 28 derniers jours, séparément pour mobile et ordinateur. L’état d’un groupe est celui de sa métrique la moins performante. Les groupes sans volume minimal de données LCP et CLS sont omis, et « Aucune donnée disponible » signifie une propriété nouvelle ou trop peu de données dans CrUX. Le tableau d’exemples est limité à 200 lignes.
Le résultat d’une seule URL dans PageSpeed Insights peut ne pas correspondre au résultat du groupe dans ce rapport, parce que PageSpeed Insights affiche en général des données par URL individuelle. Comment lire le rapport de cet outil, c’est l’objet de notre article sur PageSpeed Insights ; les seuils et la signification de chaque métrique sont expliqués dans notre article sur les Core Web Vitals.
Le rapport Insights, dans la nouvelle version annoncée le 30 juin 2025, est intégré à l’interface principale de la Search Console et remplace la version bêta autonome de Search Console Insights (Search Central Blog, 30 juin 2025, consulté le 4 octobre 2026). Il montre l’évolution des clics et des impressions, les pages et les requêtes les plus performantes, ainsi que celles en tendance haussière ou baissière. Selon l’aide de Google, l’ordre des éléments en tendance repose sur la hausse ou la baisse du nombre de clics, et non sur le pourcentage de variation. Une fiche sépare le trafic de marque du trafic non associé à une marque ; la classification est faite par l’IA, peut se tromper et n’est pas disponible pour les sous-propriétés ni pour les sites ayant peu d’impressions. Le rapport est en cours de déploiement et n’est pas forcément disponible pour tous les utilisateurs. Si vous ne l’avez pas, ou si vous ne vous y fiez pas, le filtre par expression régulière décrit plus haut vous donne la même répartition, selon vos propres règles.
L’API Search Console : quand l’interface ne suffit plus
L’interface convient aux questions ponctuelles. Pour vérifier des centaines d’adresses ou conserver plus de 16 mois d’historique, il faut l’API. Les limites selon la documentation de Google (mise à jour du 28 août 2025, consulté le 4 octobre 2026) :
- API Search Analytics (les données du rapport sur les performances) : 1 200 requêtes par minute par site et 1 200 par utilisateur, 30 000 000 par jour et 40 000 par minute par projet, plus des limites de charge à court terme et quotidiennes. Les requêtes groupées ou filtrées à la fois par page et par requête sont les plus coûteuses.
- API URL Inspection : 2 000 requêtes par jour et 600 par minute par site.
L’API URL Inspection n’indique l’état d’indexation que pour la version présente dans l’index de Google. Elle n’offre ni test en ligne ni demande d’indexation, si bien qu’aucun des deux ne peut être automatisé. La limite de 2 000 par jour s’applique à l’API, pas au bouton de l’interface. C’est ainsi que nous avons collecté les données de la section sur notre propre site, en espaçant les appels pour rester dans ces limites.
Que vérifier, et à quelle fréquence
Une routine qui découle directement de la documentation de Google :
- Au quotidien, fiez-vous aux e-mails de la Search Console sur les nouveaux problèmes ; une connexion quotidienne n’est pas nécessaire.
- Une fois par mois, et après chaque modification du contenu, ouvrez le rapport sur les performances et comparez les périodes.
- Après une mise en production, consultez le rapport sur l’indexation des pages et passez les adresses modifiées dans l’outil d’inspection d’URL, en commençant par les champs d’URL canonique.
- Lisez la position comme une évolution dans le temps, pas comme un relevé isolé.
Pour passer votre site en revue vous-même, étape par étape, utilisez notre checklist d’auto-audit du site web.
FAQ
Questions fréquentes sur la Google Search Console
C’est un outil de Google qui montre comment Google explore, indexe et affiche votre site : si une page est indexée, sur quelles requêtes elle apparaît, à quelle position et à quelle fréquence on clique dessus. Elle s’arrête au clic ; ce que fait ensuite le visiteur, c’est Google Analytics qui le mesure. Une connexion quotidienne n’est pas nécessaire, car Google vous prévient par e-mail des nouveaux problèmes.
En tant que propriétaire, ajoutez le compte de l’agence comme utilisateur avec accès complet ou avec accès limité. Seuls un propriétaire ou un utilisateur avec accès complet peuvent demander une indexation, si bien qu’un prestataire SEO a en général besoin de l’accès complet. L’entreprise doit rester le propriétaire validé. À la fin du mandat, retirez les utilisateurs de l’agence et, si elle s’est validée avec son propre jeton, retirez aussi ce jeton, faute de quoi elle peut se valider à nouveau.
Le CTR est le nombre de clics divisé par le nombre d’impressions. Une impression compte dès qu’un résultat figure sur la page de résultats ouverte, même si personne ne l’a fait défiler à l’écran ; le CTR peut donc baisser simplement parce que des impressions s’accumulent sur des positions basses ou sur des requêtes peu liées à la page. Un CTR faible ne veut pas toujours dire un titre faible.
Pour chaque requête, elle retient la position la plus élevée atteinte par un lien vers votre site, puis fait la moyenne de ces valeurs sur les requêtes. L’exemple de Google : des liens en positions 2, 4 et 6 donnent 2 ; des liens en 3, 5 et 9 donnent 3 ; la moyenne vaut 2,5. Dans le graphique, le chiffre porte sur l’ensemble du site, dans le tableau sur une ligne, d’où la différence. Google recommande de suivre l’évolution de la position dans le temps.
Non. Google indique qu’une demande ne garantit pas une inclusion dans les résultats « instantanément », ni même qu’elle ait lieu, que l’exploration peut prendre plusieurs jours, voire plusieurs semaines, et que des demandes répétées pour la même adresse ne l’accélèrent pas. Pour une page explorée mais non indexée, la page d’aide précise qu’il n’est pas nécessaire de la renvoyer. Pour de nombreuses adresses, le sitemap est la bonne voie.
Vous voulez savoir ce que la Search Console dit de votre site ?
Nous parcourons avec vous le rapport sur les performances et le rapport sur l’indexation des pages, et nous vous montrons quelles adresses Google a écartées, lesquelles n’ont pas encore eu leur chance, et lesquelles sont indexées sans que personne ne les voie.
Articles connexes
- Outils de création de site web : du choix du système à la mesure
Cinq situations : choisir un système, construire soi-même, WordPress, tester un site prêt, mesurer. Entrez dans la vôtre et passez au concret.
- 1.PageSpeed Insights : comment lire le rapport — données des utilisateurs, score Lighthouse et réglages du test
Chaque partie du rapport PageSpeed Insights expliquée : 28 jours de données réelles, score Lighthouse, mobile ou ordinateur, et pourquoi le score varie.
- 2.Thème WordPress : comment le choisir pour ne pas refaire le site dans un an
Un thème WordPress ne se choisit pas sur l’aperçu : trois informations du répertoire disent ce qu’il coûtera dans un an, et ce qui part au changement.
- 3.Créateur de site internet : ce qu’il coûte vraiment, et ce que vous pouvez en emporter
Ce que coûte un créateur de site après la première année, quatre mécanismes cachés dans les grilles tarifaires et ce que vous emportez en partant.
- 4.Page builder WordPress : ce que coûte l’éditeur visuel, et quand il cesse d’être rentable
Gutenberg, Elementor ou Divi : la licence sur trois ans, les extensions que personne ne chiffre et trois seuils où le builder coûte plus qu’il ne rapporte.
- 5.Tester un site web : comment le vérifier pour que le résultat veuille dire quelque chose
Pourquoi une mesure isolée ne prouve rien, ce qui sépare le test de laboratoire des données des visiteurs, et quoi vérifier avant la mise en ligne.
- 6.CMS : qui, dans l’entreprise, doit pouvoir modifier quoi sur le site
Ce qu’est un CMS, ses trois familles, et comment choisir avant tout produit : deux axes, fréquence des changements et coût d’une erreur.
- 7.Google Consent Mode : mesurer quand une partie des visiteurs refuse les cookies
Ce que devient la mesure après « refuser », pourquoi une PME n’aura pas la modélisation GA4, et ce qu’exigent le droit suisse et l’ePrivacy.
- 8.Installer WordPress : les réglages à faire avant le premier contenu
Installer WordPress prend quelques minutes. Ce qui coûte : la version de PHP, la structure des adresses, et une case qui peut retirer le site de Google.
- 1.